Model
DeepSeek-V4 Flash
极速日常推理模型,超低延迟吞吐。
缓存命中: ¥0.02 / M Tokens
缓存未命中: ¥1.00 / M Tokens
输出Tokens: ¥2.00 / M Tokens
| 功能名 (Features) | DeepSeek AI | Harness | 网页版 |
|---|---|---|---|
| 深度推理 (R1 Thinking) | ✔ | ✔ | ✔ |
| 免登录直达体验 | ✕ | ✕ | ✔ |
| 128K 超长上下文窗口 | ✔ | ✔ | ✔ |
| 自动化基准评测 | ✕ | ✔ | ✕ |
| RESTful API 开放接口 | ✔ | ✕ | ✕ |
| 实时全网检索增强 (Search) | ✔ | ✕ | ✔ |
全方位了解 DeepSeek api开放平台 接口规范、调用费率与 DeepSeek Harness 自动化评测体系。
经济透明的费率结构,专为极具性价比的生产规模化服务设计。
Model
极速日常推理模型,超低延迟吞吐。
Model
旗舰全能模型,深度处理复杂认知任务。
Reasoning
满血深度推理模型,激活完整长思维链。
Compatibility
100% 兼容业界主流 SDK 与生态组件。
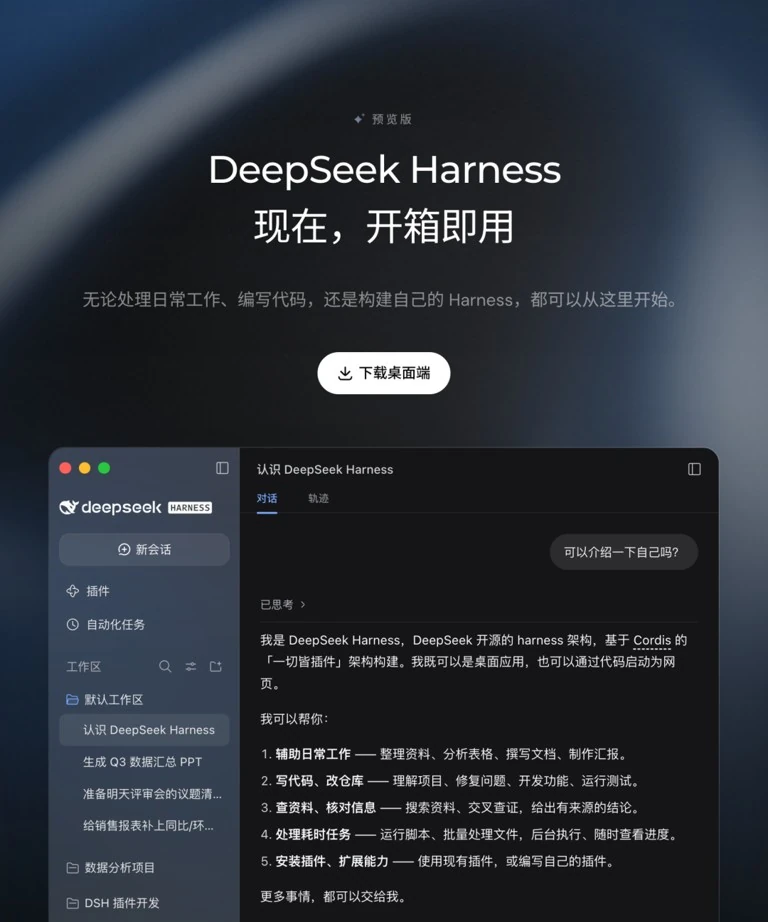
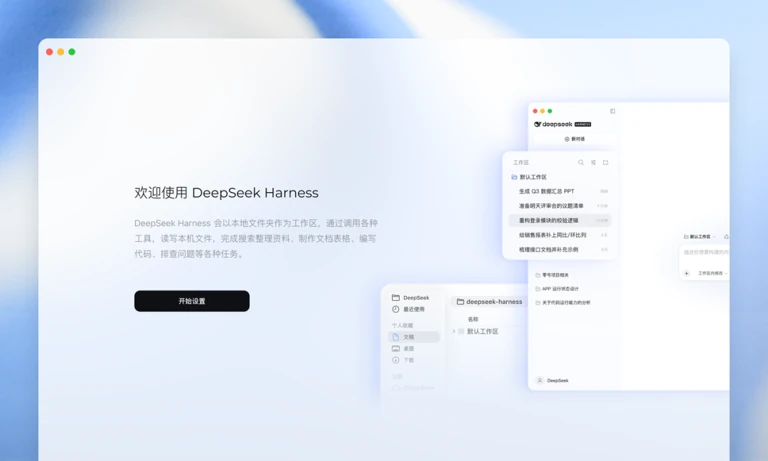
Harness 在我们的研发体系中定位为桌面型自动化与工程化工作台,持续完成工作空间管理、多文件编辑追踪与全流程基准压测。
涵盖密钥管理、网络配置与响应优化等高频问题。
登录 DeepSeek 开放平台控制台后,在「API Keys」页面点击生成密钥。密钥仅在初次创建时完整显示一次,请务必将其存入加密环境变量中,切勿硬编码上传至公共代码仓库。
对于系统提示词较长、包含知识库文档或多轮历史较多的应用,缓存命中后费用仅为原价的 1/50,并能显著缩短首字响应延迟。
请确保网络连接通畅,并尽量避免一次性在单轮对话中要求输出超出单次上限的超长内容。可通过提示词让模型「分章节输出」以保证完整性。